
مرحلہ وار گائیڈ
PDF سے متن کیسے نکالیں
تازہ کاری: 9 اکتوبر، 2026
اگر PDF ٹائپ کی گئی تھی تو اس کا متن پہلے سے اس میں موجود ہے اور بالکل درست اور فوراً پڑھا جا سکتا ہے۔ اگر وہ اسکین کی گئی تھی تو ہر صفحہ ایک تصویر ہے، اور متن کو OCR (آپٹیکل کیریکٹر ریکگنیشن) سے پہچاننا پڑتا ہے۔ FileICU کا PDF سے متن ٹول دونوں کام کرتا ہے: ٹائپ شدہ صفحات سیدھے پڑھتا ہے اور OCR صرف اسکین شدہ صفحات پر چلاتا ہے، انگریزی، فرانسیسی، ہسپانوی، جرمن، عربی اور اردو میں۔
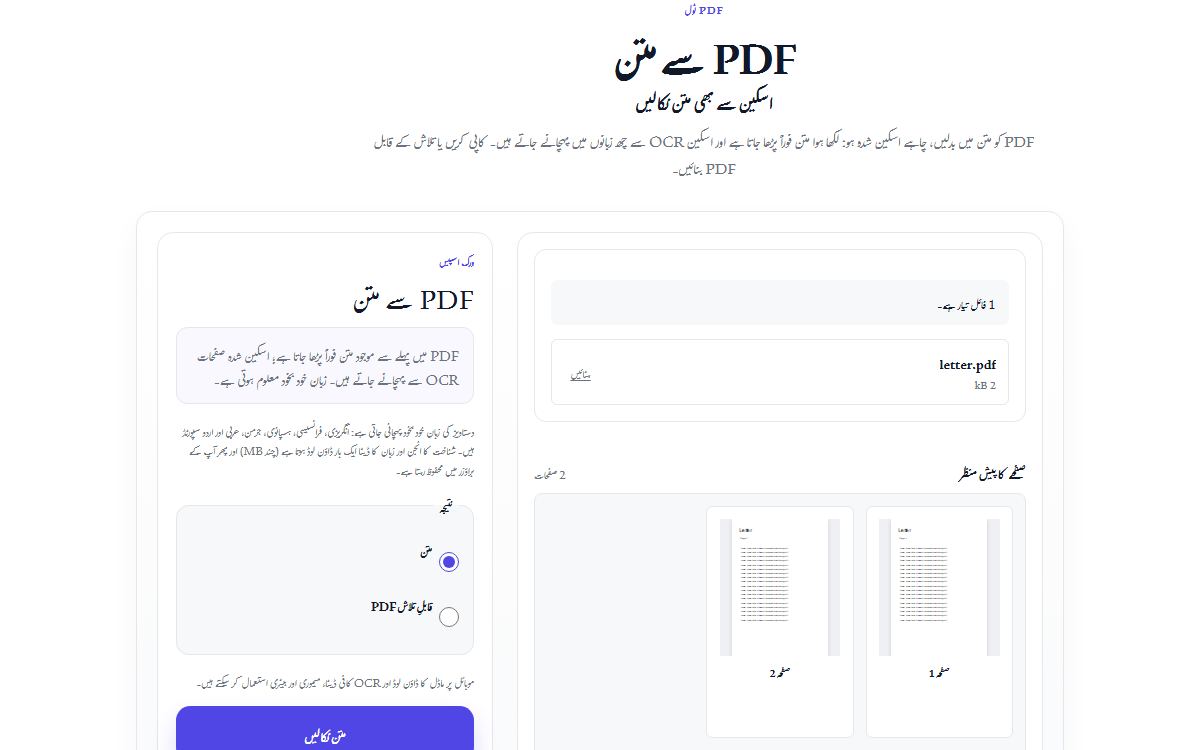
PDF سے متن سے یہ کیسے کریں
- PDF سے متن کھولیں اور اپنی PDF منتخب کریں، ٹائپ شدہ ہو یا اسکین شدہ، 25 MB تک۔
- الفاظ کاپی یا ڈاؤن لوڈ کرنے کے لیے سادہ متن چنیں، یا صفحات کی تصاویر کے ساتھ چھپی ہوئی متن کی تہہ رکھنے کے لیے قابلِ تلاش PDF۔
- متن نکالیں منتخب کریں۔ صفحات ایک ایک کر کے پروسیس ہوتے ہیں، اور اسکین شدہ صفحات کی زبان خود بخود پہچانی جاتی ہے۔
- متن کاپی کریں، اسے .txt فائل کے طور پر ڈاؤن لوڈ کریں، یا قابلِ تلاش PDF ڈاؤن لوڈ کریں۔
- اسکین شدہ صفحات کا نتیجہ ایک بار پڑھ لیں: OCR کچھ حروف غلط پڑھ سکتا ہے۔
ٹائپ شدہ PDF یا اسکین: کیسے پہچانیں
PDF کھولیں اور کوئی لفظ منتخب کرنے کی کوشش کریں۔ اگر لفظ نمایاں ہو جائے تو یہ اصل متن ہے اور بالکل درست نکلے گا۔ اگر پورا صفحہ تصویر کی طرح منتخب ہو یا کچھ نہ ہو تو صفحہ تصویر ہے اور اسے OCR چاہیے۔
بہت سی فائلوں میں دونوں ہوتے ہیں، جیسے ٹائپ شدہ رپورٹ کے ساتھ اسکین شدہ دستخط والا صفحہ۔ PDF سے متن ہر صفحے کو درست طریقے سے سنبھالتا ہے۔
مثال: ایک اسکین شدہ خط
دفتر میں اسکین کیا گیا دو صفحات کا خط دو تصاویر والی PDF کے طور پر آتا ہے۔ سادہ متن آپ کو خط کے الفاظ دیتا ہے، جو کسی ای میل یا دستاویز میں پیسٹ کرنے کے لیے تیار ہوتے ہیں۔ قابلِ تلاش PDF آپ کو بالکل اسکین جیسی فائل دیتی ہے، مگر اب آپ اس میں کوئی نام تلاش کر سکتے ہیں یا کوئی پیراگراف کاپی کر سکتے ہیں۔
جب کوئی زبان پہلی بار پہچانی جاتی ہے تو اس کا OCR ڈیٹا اسی ویب سائٹ سے ایک بار ڈاؤن لوڈ ہوتا ہے، تقریباً 0.7 سے 3 MB، اور انجن کے لیے تقریباً 1.5 MB مزید۔ آپ کی PDF کبھی اس ڈاؤن لوڈ کا حصہ نہیں ہوتی۔
OCR کے بہتر نتائج کیسے لیں
OCR صاف، سیدھی اور اعلیٰ ریزولوشن والی چھپائی پر سب سے اچھا کام کرتا ہے۔ ہلکی نقول، صفحات کی ٹیڑھی تصاویر، باریک حروف اور آرائشی فونٹس درستی کم کرتے ہیں، اور ہاتھ کی لکھائی سپورٹ نہیں ہوتی۔
- ممکن ہو تو صفحے کی تصویر لینے کے بجائے 300 DPI پر اسکین کریں۔
- صفحہ سیدھا اور روشنی یکساں رکھیں۔
- پہچان کے بعد نام، نمبر اور رقمیں خود دیکھ کر چیک کریں۔
عام مسائل
- نکالا گیا متن غلط ترتیب میں آتا ہے۔
- کئی کالموں والی ترتیب اور ٹیکسٹ باکس آپ کی پڑھنے کی ترتیب سے مختلف ترتیب میں پڑھے جا سکتے ہیں۔ ضرورت کے حصے کاپی کریں یا انہیں اصل سے ملا لیں۔
- OCR کے بعد کچھ حروف غلط ہیں۔
- اسکین شاید کم ریزولوشن یا غیر واضح ہے۔ صفحہ زیادہ واضح اسکین کریں، یا چند غلط حروف ہاتھ سے درست کر لیں۔
- عربی یا اردو متن ٹھیک سے نہیں پہچانا جاتا۔
- صاف نسخ چھپائی بہترین نتائج دیتی ہے۔ نستعلیق، جو زیادہ تر چھپی اردو میں استعمال ہوتا ہے، باریک حروف اور کم کنٹراسٹ والے اسکین کم درست نتائج دیتے ہیں۔
- میرے فون پر یہ سست ہے۔
- OCR بہت میموری اور پروسیسنگ استعمال کرتا ہے۔ مختصر دستاویزات، یا لمبے اسکین کے لیے کمپیوٹر، بہتر کام کرتے ہیں۔
اس کام کے ٹولز
- PDFPDF سے تبدیلی
PDF سے متن
کسی بھی PDF سے متن نکالیں، اسکین شدہ صفحات سمیت، پھر اسے کاپی کریں، ڈاؤن لوڈ کریں یا تلاش کے قابل PDF بنائیں۔
- تصویرنکالیں
تصویر سے متن
تصاویر، اسکرین شاٹس اور اسکین شدہ تصاویر سے OCR کے ذریعے متن نکالیں، پھر اسے کاپی یا ڈاؤن لوڈ کریں۔
- متنگنتی
الفاظ شمار کنندہ
لکھتے ہوئے الفاظ، حروف، جملے اور پڑھنے کا اندازاً وقت معلوم کریں۔
- PDFPDF میں تبدیلی
متن سے PDF
ٹائپ کیے گئے متن کو قابلِ تبدیل فونٹ سائز، صفحے کے سائز اور حاشیوں کے ساتھ PDF میں ڈھالیں۔